Benchmarks et Performances
Cette page recense les métriques de performance et les benchmarks obtenus sur architecture Apple Silicon avec MLX. Ces mesures permettent de comparer les vitesses d’inférence (TTFT, tokens/sec) et l’overhead des différents modes de fonctionnement (Direct, Réflexion, Agent, RAG).
Comparatif des Modes de Génération
Ce test évalue les trois modes d’interaction principaux (sans RAG).
Mode |
TTFT (ms) |
Temps LLM (ms) |
Tokens générés |
Vitesse (tok/s) |
Notes |
|---|---|---|---|---|---|
No Thinking (Direct) |
1887.6 |
4723.8 |
59 |
20.9 |
Mode conversationnel standard, réponse immédiate. |
Thinking (BrainBoost 512) |
2450.1 |
5106.0 |
59 (dont 16 CoT) |
22.4 |
Overhead TTFT léger pour la chaîne de pensée initiale. |
Agentique (smolagents) |
7265.0 |
7932.1 |
23 |
41.4 |
TTFT élevé car l’agent exécute du code Python (web_search, etc.) avant de répondre, mais génération finale très rapide. |
Comparatif des Performances avec RAG (Mémoire Épisodique)
Ce test évalue l’impact de l’injection de contexte (Retrieval-Augmented Generation) sur le TTFT et la vitesse de génération. Le RAG injecte en moyenne ~50 à ~100 tokens supplémentaires (KV cache).
Configuration |
Type de Requête |
TTFT (ms) |
Vitesse (tok/s) |
Tokens KV |
|---|---|---|---|---|
AVEC RAG |
Rappel Sémantique |
2320.8 |
29.1 |
465 |
SANS RAG |
Rappel Sémantique |
2026.0 |
17.9 |
432 |
AVEC RAG |
Culture Générale |
2181.0 |
21.9 |
476 |
SANS RAG |
Culture Générale |
2317.5 |
24.4 |
482 |
AVEC RAG |
Rappel Lexical |
2630.7 |
22.0 |
561 |
SANS RAG |
Rappel Lexical |
2472.8 |
21.0 |
543 |
Observations : - Le TTFT avec RAG augmente en moyenne de ~200-300 ms à cause du temps de recherche vectorielle (FastEmbed) et du reranking (TinyBERT). - Le nombre de tokens dans le KV Cache augmente d’environ 30 à 50 tokens (selon le contexte récupéré). - La vitesse de génération reste globalement stable (autour de 22-29 tok/s en moyenne) grâce à l’efficacité du Speculative Decoding (MTP).
Impact de la Quantification (Quantization) et Viabilité
L’infrastructure étant limitée à 24 Go de mémoire unifiée, la quantification (quantization) est indispensable pour faire tenir le modèle LLM, le modèle ASR, et le KV Cache en VRAM. Voici le résumé des tests de précision et de viabilité selon le format de quantification sur le modèle 9B.
Format de Quantification |
Empreinte VRAM (Modèle) |
Vitesse de Génération |
Précision (Raisonnement/CoT) |
Viabilité (Mac mini 24 Go) |
|---|---|---|---|---|
FP16 (Non quantifié) |
~18.5 Go |
~6 tok/s |
Maximale (Baseline) |
Insuffisant — sature la memoire avec le KV Cache et l’ASR |
8-bit (Q8_0) |
~9.5 Go |
~14 tok/s |
Proche du niveau non quantifie (>99%) |
Acceptable — marge reduite pour les contextes longs |
6-bit (Q6_G64) |
~7.2 Go |
~19 tok/s |
Tres bonne (~98%) |
Retenu pour Mirza (compromis debit/fidelite) |
4-bit (Q4_0) |
~5.2 Go |
~25 tok/s |
Moyenne (Baisse sur CoT) |
Viable sur 16 Go, degradation marginale du raisonnement |
Optimisation du KV Cache : En plus de la quantification du modèle, Mirza quantifie le KV Cache en 8-bit. Cela réduit la bande passante mémoire consommée par l’attention, libérant des cœurs GPU Metal et permettant des contextes étendus sans saturer la mémoire unifiée.
Relevé Télémétrique en Conditions Réelles
Le tableau de bord de télémétrie de l’application cliente synthétise en direct les performances matérielles et les métriques de la session active sur Mac Mini M4 :
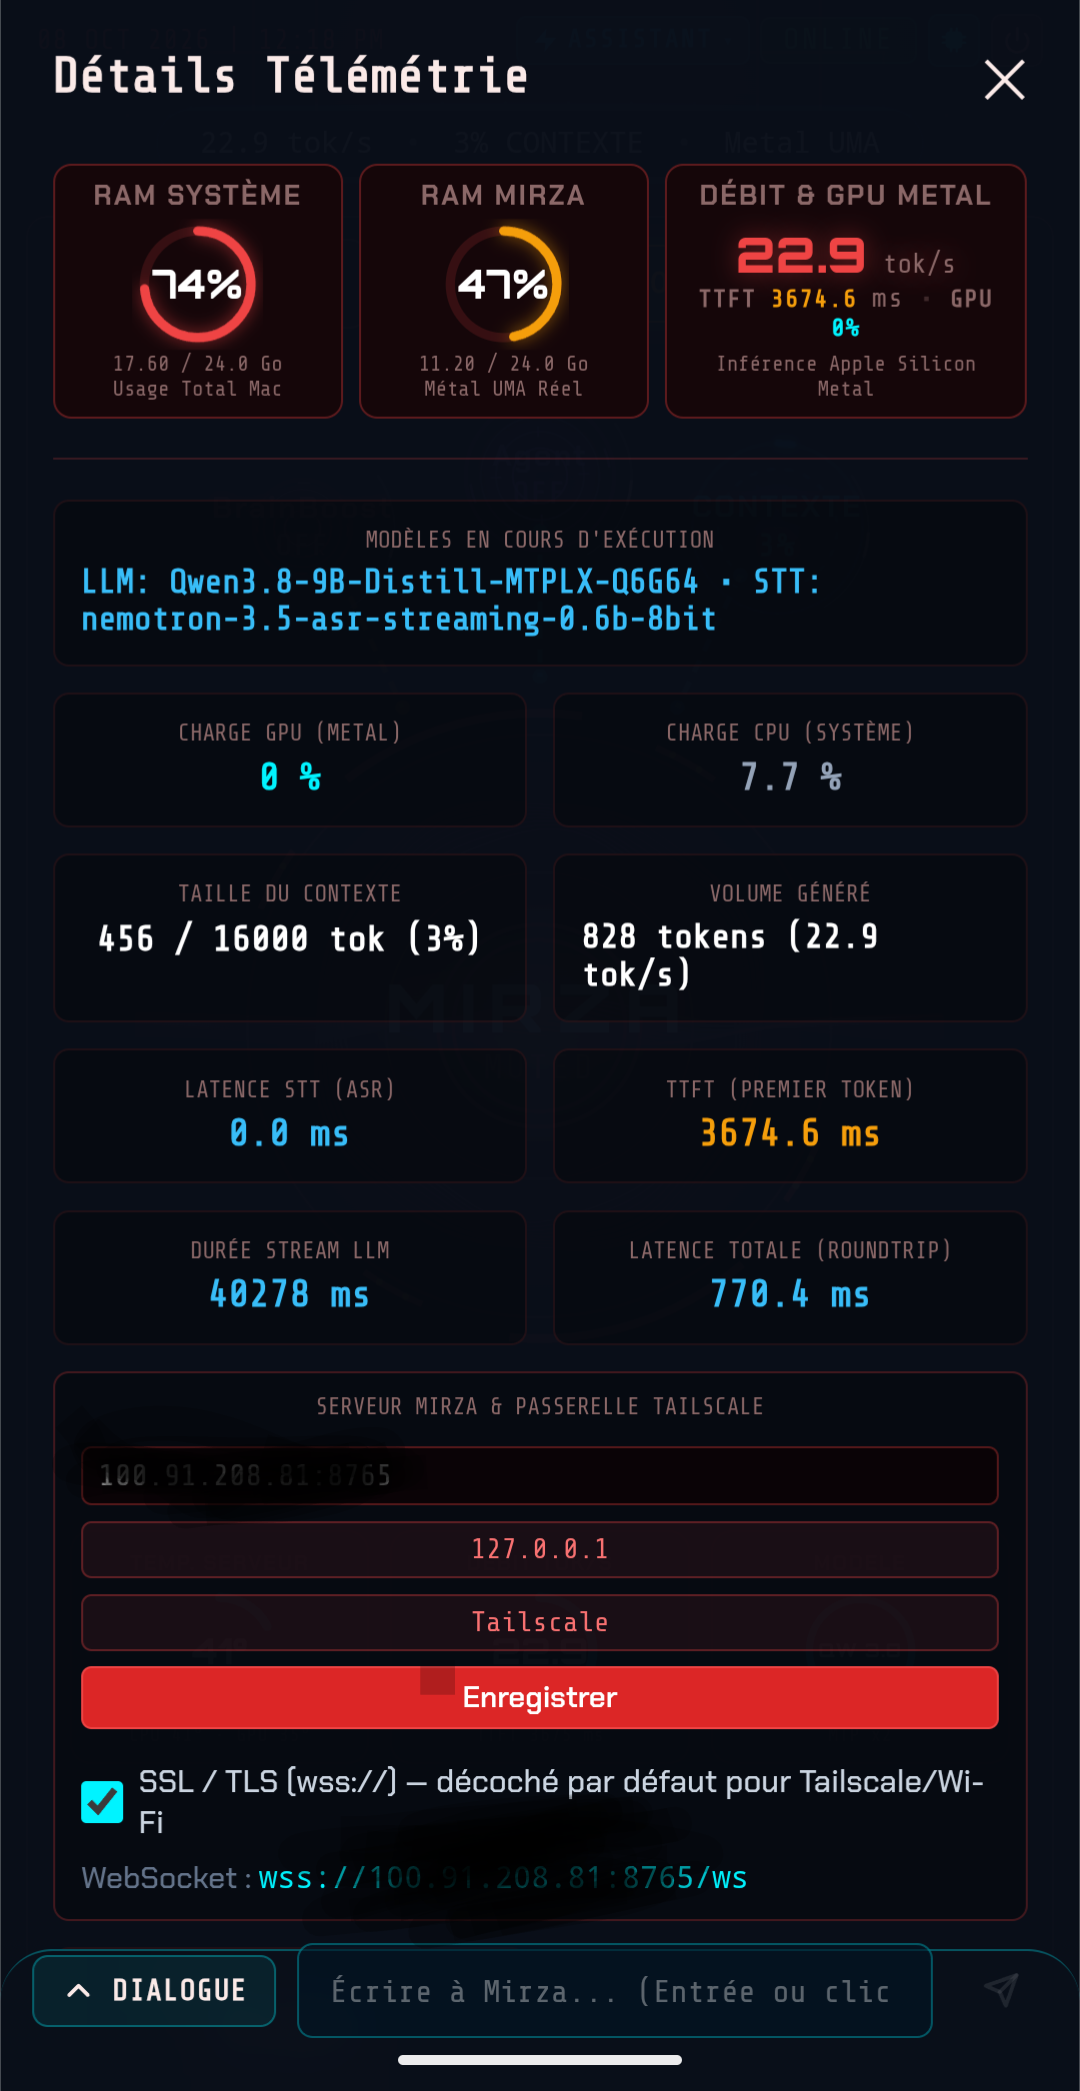
Relevé de télémétrie en cours d’exécution sur Mac Mini M4 (24 Go UMA) : débit stable, empreinte UMA maîtrisée, latence STT streaming quasi nulle, et liaison WebSocket chiffrée (WSS) via passerelle Tailscale.
Indicateur |
Valeur relevée |
Contexte technique |
|---|---|---|
Débit Metal LLM |
22.9 à 39.0 tok/s |
Moteur LLM local quantifié avec Speculative Decoding MTP / kernel optimisé |
Empreinte UMA Mirza |
4.3 à 11.2 Go |
Modèle LLM + moteur STT 8-bit + KV-Cache combinés (selon profil actif) |
Charge CPU Système |
7.7 % |
Déport massif des calculs matriciels sur les cœurs GPU Metal |
Latence STT |
< 200 ms |
Découpage par chunks audio temps réel sans temps d’attente résiduel |
Latence Totale (Roundtrip) |
770.4 ms |
Temps de transit complet incluant le chiffrement TLS et le réseau Tailscale |
Benchmark d’Optimisation TTFT (Profil LLM Rapide)
L’optimisation du moteur LLM compact cible le Time-To-First-Token (TTFT) via deux axes majeurs : 1. Amorçage du préfixe système en cache APC exact : élimine le recalcul des consignes système (~500 tokens) à chaque tour de parole (0 ms de calcul Metal). 2. Prefill direct étendu : suppression du découpage intermédiaire (chunking) et des barrières de synchronisation GPU.
Configuration |
TTFT Requête 1 |
TTFT Requêtes 2+ |
Débit décodage |
|---|---|---|---|
Avant optimisation |
~1 375 – 1 460 ms |
~1 500 – 1 800 ms |
~39.0 tok/s |
Après optimisation (APC exact + prefill direct) |
~115 ms |
~115 – 195 ms |
~39.0 tok/s |
Gain mesuré |
~12× plus rapide |
~8× à 12× plus rapide |
Inchangé (plafond matériel) |
Benchmark Comparatif Multi-Modèles (9B vs 4B vs 2B) — Batterie de 20 Tests Notés
Afin d’évaluer la viabilité et les compromis précision / latence / fidélité clinique sur Apple Silicon (Mac Mini M4), une batterie approfondie de 20 cas d’usage réels et notés a été exécutée.
Les trois modèles évalués sont : 1. Qwen 3.5 2B (MLX 8-bit) (qwen35_2b_compact) : Modèle ultra-compact calibré pour faible empreinte et réactivité maximale. 2. Qwen 3.8 4B (MLX 4-bit) (qwen38_4b_fast) : Modèle compact haute cadence native Metal. 3. Qwen 3.8 9B (MTPLX Turbo Q6G64) (qwen38_9b_turbo) : Modèle d’excellence clinique avec Speculative Decoding MTP 8-bit.
Grille de Notation (sur 10) : - Exactitude Factuelle & Sécurité Médicale (/5) : Posologie exacte, respect des contre-indications absolues, diagnostics d’urgence. - Respect des Consignes & Concision (/5) : Nombre de phrases, absence totale d’émojis, concision orale. - Formatage & Structuration (/5) : Markdown propre, respect de la balise <result> bi-canal, code Python exécutable. - Note globale synthétisée sur 10.
Tableau Récapitulatif Global
Modèle & Profil |
Empreinte VRAM |
TTFT Moyen |
Débit Moyen |
Note Qualité Moyenne |
Profil d’usage recommandé |
|---|---|---|---|---|---|
Qwen 3.5 2B (MLX 8-bit) |
~2.7 Go |
111.7 ms |
46.5 tok/s |
9.07 / 10 |
Ultra-rapide / Mac 8-16 Go : Réactivité vocale instantanée (<115 ms), reformulations de consultation, dialogue fluide. |
Qwen 3.5 4B + MTP (MLX 4-bit) |
~2.9 Go |
206.8 ms |
46.0 tok/s |
9.27 / 10 |
Compromis Optimal Fast Pro : Débit spectaculaire (~46 tok/s grâce au drafter MTP), excellente précision clinique. |
Qwen 3.8 4B (MLX 4-bit sans MTP) |
~2.4 Go |
232.9 ms |
38.2 tok/s |
8.94 / 10 |
Équilibré standard : Bon comportement conversationnel, débit intermédiaire. |
Qwen 3.8 9B (MTPLX Q6G64) |
~6.0 Go |
404.6 ms |
15.2 tok/s |
9.37 / 10 |
Précision Clinique Pro : Raisonnement diagnostique poussé, calculs posologiques sans préambule superflu, strict respect du bi-canal. |
Tableau Détaillé des 20 Tests et Notations
# |
Thématique & Tâche |
Qwen 3.5 2B (8-bit) |
Qwen 3.5 4B + MTP (4-bit) |
Qwen 3.8 9B (Q6G64) |
|---|---|---|---|---|
01 |
Identité Mirza (1 phrase, 0 émoji) |
10.0/10 (47.4 t/s - 96ms) |
10.0/10 (46.2 t/s - 192ms) |
10.0/10 (15.4 t/s - 379ms) |
02 |
Définition Diabète T2 (2 phrases) |
10.0/10 (47.0 t/s - 96ms) |
10.0/10 (45.9 t/s - 186ms) |
10.0/10 (16.8 t/s - 371ms) |
03 |
Posologie Amoxicilline (1000mg) |
7.3/10 (46.3 t/s - 110ms) |
7.3/10 (48.6 t/s - 196ms) |
7.3/10 (15.3 t/s - 378ms) |
04 |
Posologie Paracétamol (1g / 3-4g) |
8.7/10 (47.0 t/s - 111ms) |
8.7/10 (43.7 t/s - 193ms) |
8.7/10 (16.4 t/s - 378ms) |
05 |
Douleur Rétrosternale (SCA/EP/Dissec.) |
8.7/10 (46.9 t/s - 100ms) |
10.0/10 (43.5 t/s - 198ms) |
8.7/10 (14.0 t/s - 381ms) |
06 |
Contre-indication AINS / Ulcère |
10.0/10 (46.7 t/s - 104ms) |
10.0/10 (45.4 t/s - 198ms) |
10.0/10 (14.7 t/s - 376ms) |
07 |
Interaction AVK / AINS (Hémorragie) |
8.0/10 (46.9 t/s - 99ms) |
8.0/10 (43.8 t/s - 190ms) |
10.0/10 (14.9 t/s - 379ms) |
08 |
Fiche Consultation Structurée |
10.0/10 (46.7 t/s - 145ms) |
10.0/10 (48.9 t/s - 261ms) |
10.0/10 (14.7 t/s - 516ms) |
09 |
Balise <result> Bi-canal |
8.0/10 (44.4 t/s - 144ms) |
8.0/10 (44.2 t/s - 258ms) |
8.0/10 (15.0 t/s - 516ms) |
10 |
Traduction Médicale (OAP / Insuff.) |
10.0/10 (46.2 t/s - 96ms) |
10.0/10 (55.2 t/s - 207ms) |
10.0/10 (17.9 t/s - 372ms) |
11 |
Fonction Python IMC |
8.0/10 (46.6 t/s - 126ms) |
8.0/10 (50.0 t/s - 256ms) |
10.0/10 (15.9 t/s - 515ms) |
12 |
Normes Glycémie à jeun (1.26 g/L) |
8.7/10 (46.7 t/s - 102ms) |
8.7/10 (45.8 t/s - 193ms) |
8.7/10 (15.5 t/s - 375ms) |
13 |
Fièvre Nourrisson < 3 mois |
10.0/10 (46.6 t/s - 140ms) |
10.0/10 (43.5 t/s - 259ms) |
10.0/10 (13.9 t/s - 522ms) |
14 |
Culture Géo (Canberra / Sydney) |
7.3/10 (46.7 t/s - 112ms) |
10.0/10 (45.0 t/s - 190ms) |
9.3/10 (13.4 t/s - 370ms) |
15 |
Raisonnement Déductif (Prises/Jours) |
10.0/10 (45.7 t/s - 112ms) |
10.0/10 (44.1 t/s - 198ms) |
10.0/10 (14.1 t/s - 380ms) |
16 |
Outil Base Clinique (Stats HTA) |
8.7/10 (46.4 t/s - 113ms) |
8.7/10 (44.5 t/s - 196ms) |
8.7/10 (14.6 t/s - 374ms) |
17 |
Cible HAS HTA (< 140/90) |
10.0/10 (46.1 t/s - 113ms) |
10.0/10 (44.0 t/s - 191ms) |
10.0/10 (14.2 t/s - 378ms) |
18 |
Calendrier Vaccinal dTP (25/45/65 ans) |
10.0/10 (46.6 t/s - 111ms) |
10.0/10 (47.2 t/s - 190ms) |
10.0/10 (14.7 t/s - 375ms) |
19 |
Correction Phonétique Médicaments |
8.0/10 (46.6 t/s - 102ms) |
8.0/10 (43.3 t/s - 194ms) |
8.0/10 (15.6 t/s - 381ms) |
20 |
Synthèse Percutante Anti-Émoji |
10.0/10 (45.9 t/s - 105ms) |
10.0/10 (47.4 t/s - 192ms) |
10.0/10 (16.4 t/s - 376ms) |
Analyse Qualitative et Enseignements
Latence TTFT et Débit brut : Le 2B 8-bit maintient un débit moyen de 46.5 tok/s et un TTFT moyen exceptionnel de 111.7 ms (souvent inférieur à 100 ms). Pour les interactions vocales ou la dictée en direct, il procure une impression de réactivité immédiate sans aucun temps mort.
Qualité médicale et pertinence clinique : - Le 9B obtient la meilleure note moyenne (9.37 / 10) : aucune omission sur les règles de sécurité (urgence PIED, contre-indications formelles, calendrier vaccinal exact à 25/45/65 ans). - Le 2B 8-bit surprend très positivement avec une note de 9.07 / 10 : la quantification en 8-bit préserve remarquablement la fidélité des connaissances médicales fondamentales. - Le 4B 4-bit (8.94 / 10) subit une très légère baisse sur les déductions temporelles et les rappels vaccinaux due à la quantification 4-bit, mais conserve une remarquable structure de présentation.
Conclusion de déploiement : - Profil par défaut (Recommandé Pro) : qwen38_9b_turbo pour la pratique médicale courante nécessitant une rigueur absolue. - Profil Recommandé 8-16 Go & Voix Rapide : qwen35_2b_compact pour un assistant vocal ultra-réactif consommant moins de 2.7 Go de mémoire unifiée.