Architecture Logique et Fonctionnelle
Cette section décrit le modèle de données comportemental de Mirza : comment les signaux transitent de la parole à la réponse audio, quels mécanismes de filtrage interviennent à chaque étape, et comment le protocole bi-canal voix/widget est orchestré.
Vue d’Ensemble
Mirza est structuré autour d’une boucle événementielle asyncio centrale pilotant cinq sous-systèmes qui communiquent via des queues en mémoire (sans broker externe) :
Sous-système |
Composant principal |
Rôle & Performance |
|---|---|---|
Capture |
|
Détection VAD temps réel (chunk 512 samples), buffer PCM, segmentation de parole |
Transcription |
Moteur STT streaming local |
Transcription STT temps réel locale (< 200 ms) |
Raisonnement |
Moteur LLM local & distant · |
Moteur LLM local : TTFT ~115–450 ms, 28–39 tok/s (décodage spéculatif MTP & cache APC) |
Filtrage |
|
Séparation temps réel pensée / voix / widget résultat (balises |
Synthèse & Diffusion |
Moteur TTS neural · |
TTS pipelined dès la première clause (< 400 ms) + streaming audio binaire WSS |
Diagramme de Flux Logique Global
Cycle de Vie d’un Événement Vocal
Le tableau suivant détaille la séquence temporelle d’une interaction complète mesurée sur Apple Silicon (mémoire unifiée UMA) :
Étape |
Événement |
Latence mesurée |
Description |
|---|---|---|---|
1 |
|
0 ms |
Détection d’énergie vocale par le VAD client. Le serveur initialise le tampon PCM. |
2 |
Transfert binaire continu |
~120 ms/bloc |
Blocs Int16 16 kHz envoyés bruts via WebSocket ( |
3a |
|
silence > 500 ms |
Fin de parole détectée. Le serveur rassemble les trames en mémoire et démarre l’ASR. |
3b |
|
durée < 300 ms |
Bruit parasite détecté. Les octets sont purgés sans solliciter le LLM. |
4 |
Transcription STT |
< 200 ms |
Le moteur STT local transcrit l’audio en streaming sur GPU Metal. |
5 |
Génération LLM (TTFT) |
~115–450 ms |
Premier token émis. Le modèle génère à 28–39 tok/s selon le profil local sélectionné. |
6 |
Early TTS trigger |
≈ 3–4 mots |
Le découpeur de phrases enclenche la synthèse dès la première clause complète. |
7 |
|
< 400 ms post-TTFT |
Premier chunk audio PCM envoyé au client via WebSocket binaire. |
Protocole Bi-Canal — Restitution Documentaire et Code (<result> / <code_view>)
Pour concilier une synthèse vocale fluide avec la restitution de données denses
(code informatique, tableaux, démonstrations formelles, LaTeX, URLs), Mirza implémente un protocole bi-canal strict
géré par le StreamingTextFilter :
Règles du protocole :
Tout ce qui est balisé dans
<result>...</result>,<code_view>...</code_view>ou<code>...</code>est strictement exclu de la voix et redirigé en temps réel vers le visualiseur de documents ou le widget de code.Durant la génération de code ou l’exécution d’outils par l’agent, un réacteur oscillant s’active visuellement (
GÉNÉRATION IN PROGRESSouAGENT IN PROGRESS).La partie vocale ne contient jamais de markdown, d’URLs brutes, ni d’émojis, et annonce sobrement : « Voici le code demandé. J’ai archivé le document complet. » ou « Je suis en train d’archiver les résultats. ».
La règle est encodée dans le
systemPromptdePromptConfiget est appliquée côté serveur par leStreamingTextFilterindépendamment du comportement du modèle.
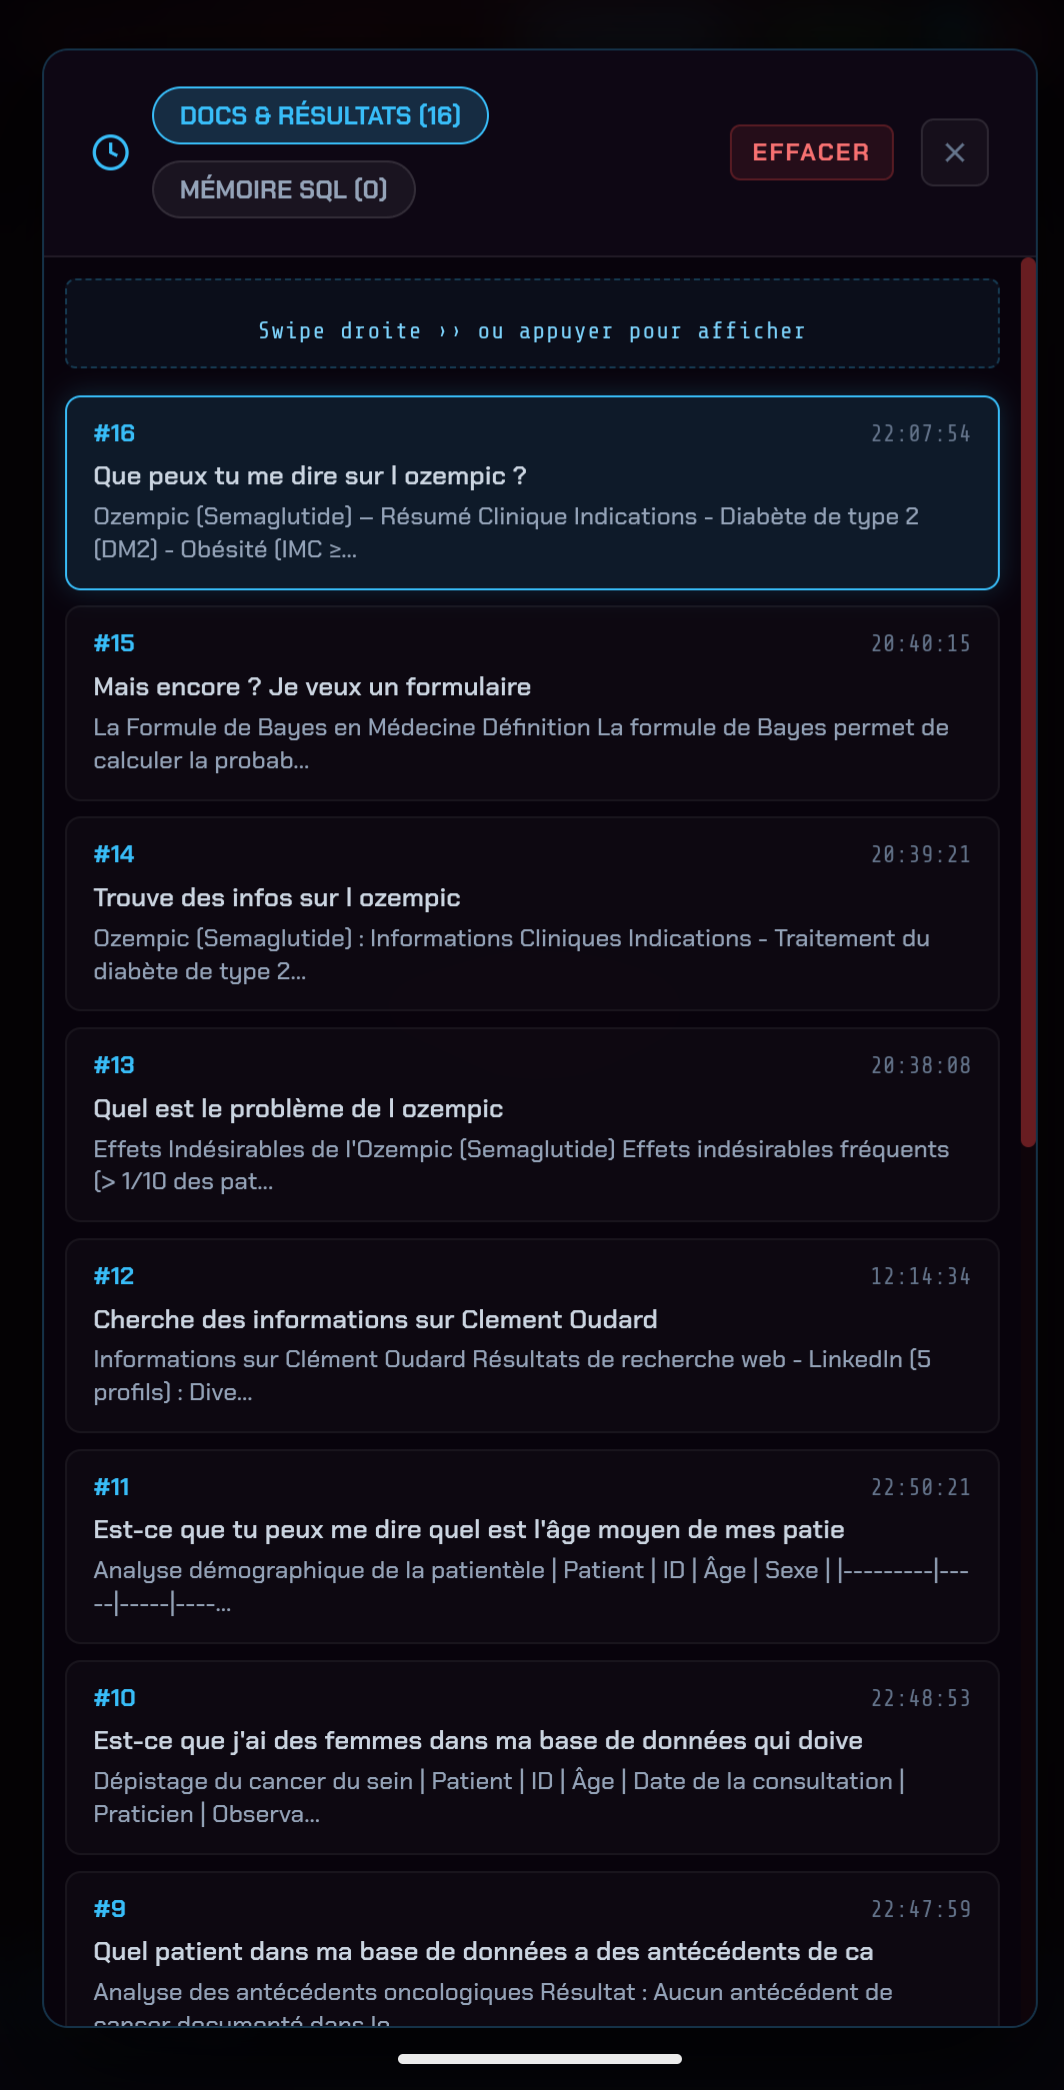
Restitution des fiches structurées dans le tiroir DOCS & RÉSULTATS : les démonstrations complexes (ex: formule de Bayes), les extractions documentaires et les requêtes cliniques sont isolées du canal audio pour préserver la concision orale.
Mode d’Écoute : VAD Continu vs Push-To-Talk
Mirza gère l’acquisition audio via deux paradigmes d’interaction distincts, permettant de s’adapter aux environnements calmes ou bruyants :
Mode |
VAD Continu (Voice Activity Detection) |
Push-To-Talk (PTT) |
|---|---|---|
Déclenchement |
Automatique dès que l’énergie vocale dépasse le seuil (VAD neural). |
Manuel. L’utilisateur appuie pour commencer/arrêter. |
Idéal pour |
Environnements calmes, conversations mains-libres fluides. |
Environnements très bruyants, pour éviter les déclenchements intempestifs. |
Fonctionnement interne |
Le flux micro est analysé par chunks de 512 samples. Le silence (>500ms) déclenche le STT. |
L’enregistrement s’ouvre au clic, se clôture au relâchement. Pas de coupure sur les pauses. |
Gating Acoustique et Anti-Larsen
Sur smartphone et périphériques duplex, le haut-parleur peut réinjecter la voix de Mirza dans le microphone. La plateforme neutralise ce risque via une architecture à triple barrière :
Barrière |
Implémentation |
Description |
|---|---|---|
Half-Duplex Gate |
|
Le serveur positionne |
MuteGain WebAudio |
|
Le |
Tail Silence Debounce |
|
Une temporisation de 300 ms après la fin de la restitution TTS empêche les échos acoustiques résiduels de redéclencher l’ASR. |
Modèle de Raisonnement LLM
Mirza supporte trois modes de raisonnement configurables depuis l’interface :
Architecture Agentique et Outils (smolagents CodeAgent)
En mode agentique, Mirza s’appuie sur le framework smolagents et son exécuteur CodeAgent optimisé pour MLX. L’utilisateur configure granularément les outils autorisés directement depuis la modale dédiée :
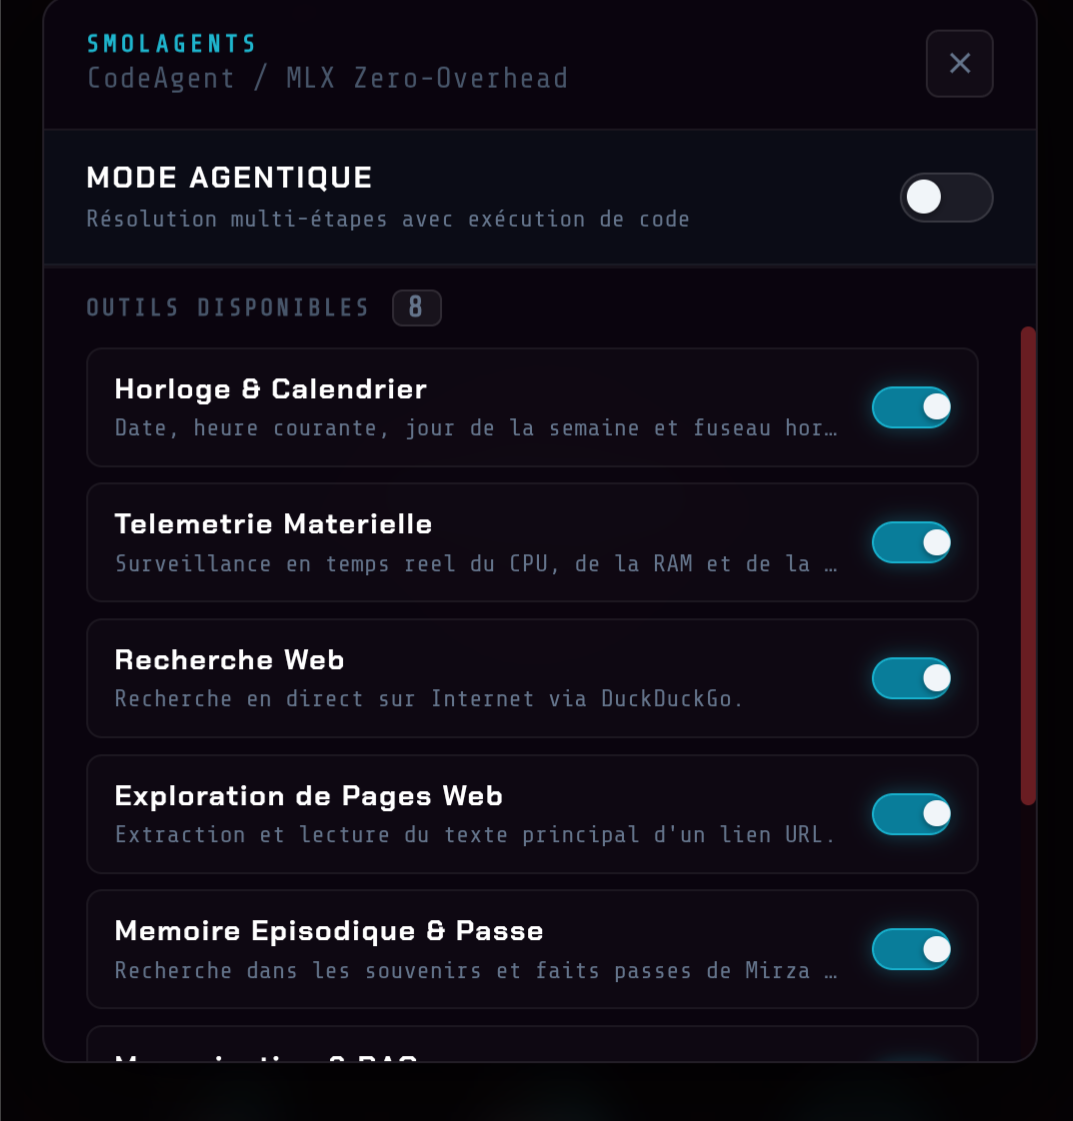
Panneau SMOLAGENTS CodeAgent sur mobile : activation du mode agentique et bascule individuelle des outils d’exécution locale (Horloge, Télémétrie, Recherche Web DuckDuckGo, Crawler d’URLs, Mémoire Épisodique et RAG).